早上到公司,发现昨晚什么都没跑
有个在深圳做机房的朋友,去年跟我抱怨过一件事。
他说他某天上午九点半到公司,发现昨晚定时跑的发布任务一台都没执行。先怀疑设备掉了,查了半小时,设备全在线;又怀疑脚本坏了,回滚了一个版本,还是没跑。
最后是在任务面板里看到状态写着「已暂停」——流程里有个步骤在等人点一下。任务凌晨两点挂的,他九点半才知道,中间七个多小时什么都没发生。
他后来跟我说了一句话:我不怕它挂,我怕的是挂了没人告诉我。
这篇文章就解决这一件事。站内有一篇讲苹果群控设备巡检的,那篇讲的是「你主动去查」——打开中控过一遍在线状态、翻执行记录、把可疑设备问出来。这篇讲的是反方向:让系统主动来找你。
为什么要分开做?因为两者能发现的问题不一样。
巡检擅长发现慢性的东西:某几台设备最近老掉线、某个账号的表现一直在下滑、线材开始接触不良。这些都不紧急,但拖着会出事。
告警擅长处理突发的:半夜两点那个定时任务整体失败了、某台设备从昨天下午就掉线了、脚本跑到一半卡在某一步不动了。这些不能等。
第一步:先让它「看得见」
告警的前提是监控。所以第一件事不是配通知,是把任务面板读熟。
打开任务面板,每一条任务上会显示四个字段:状态、来源、跑了多少台设备、成功和失败数量,以及执行时间。来源会标出这条任务是 AI 会话触发的、工作流编辑器试跑的,还是定时任务自动触发的——命名过的定时规则还会带上名字。
四个状态里,两个最需要认识:
- 部分成功:流程本身跑通了,但有设备掉队。这个状态最容易被当成「成功」忽略掉,而它恰恰是问题最早的信号——比如一批 30 台里固定有 4 台失败,通常是那 4 台的线材或系统版本有问题。
- 已暂停:通常是流程里存在「等人操作」的步骤,系统在那里停住等你。如果这个流程本来就是无人值守跑的,那它一暂停就没人推进,会一直挂在后台。
点开一条任务,能看到每一台设备单独的状态;失败的设备会给出错误说明。这一步是判断影响面的关键:是整批的问题,还是集中在某几台。
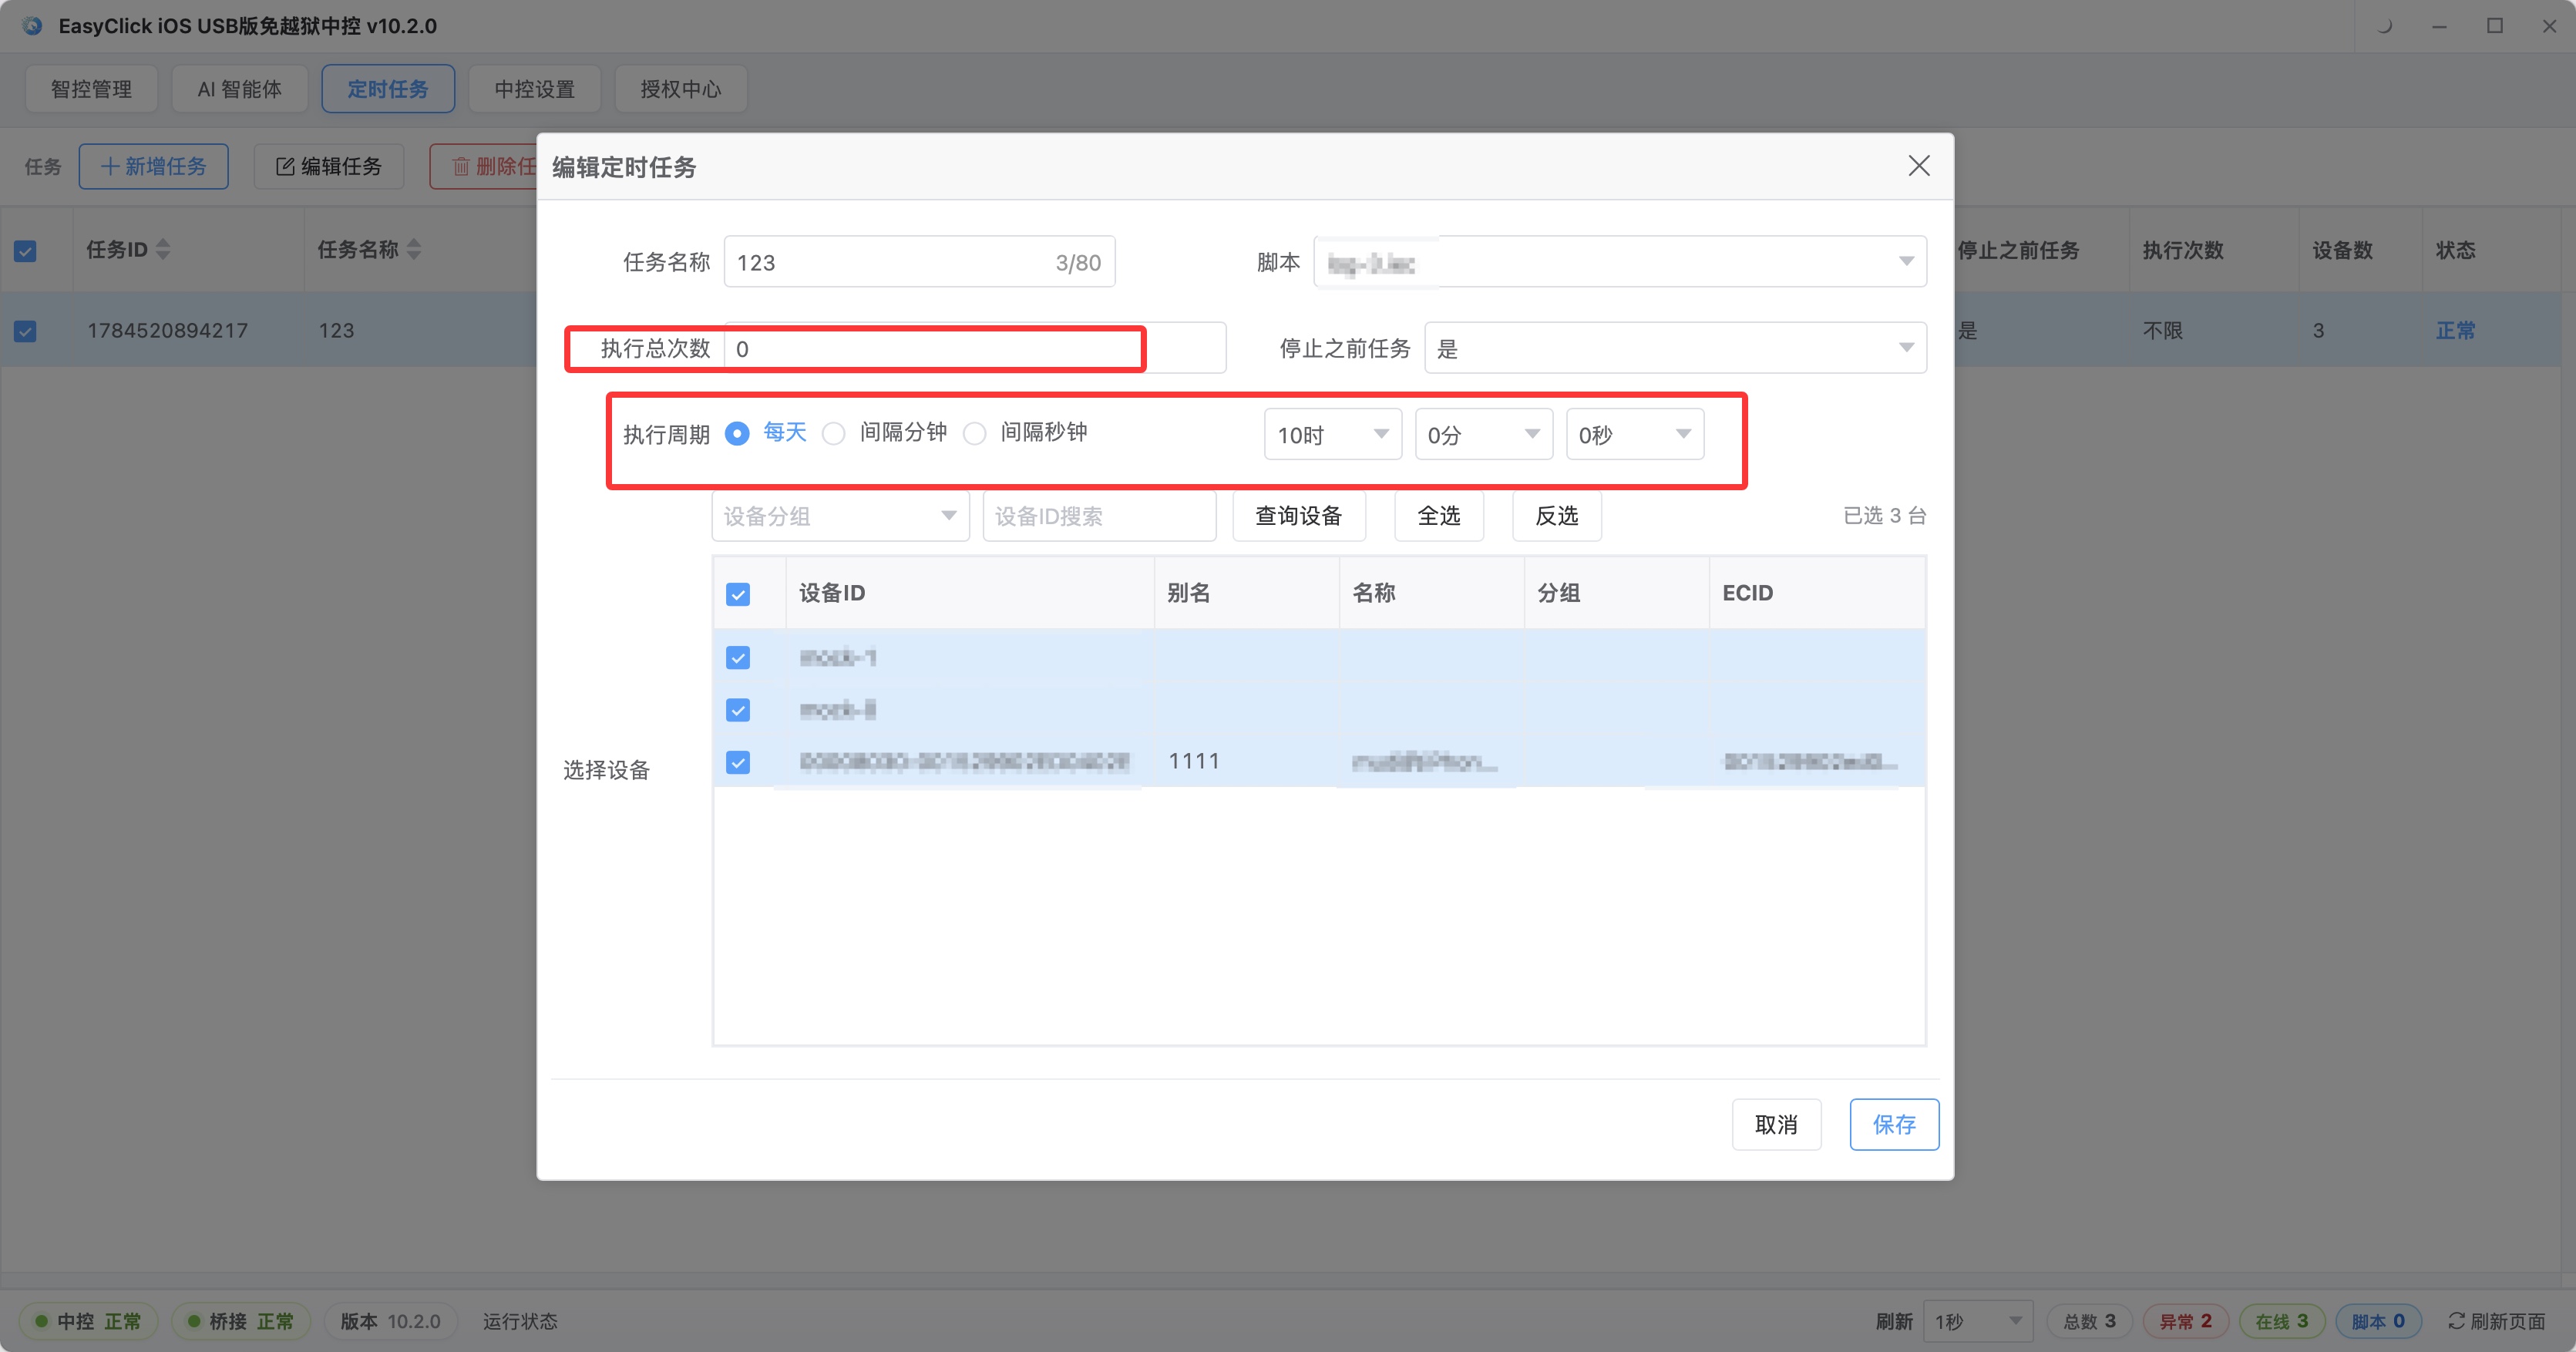
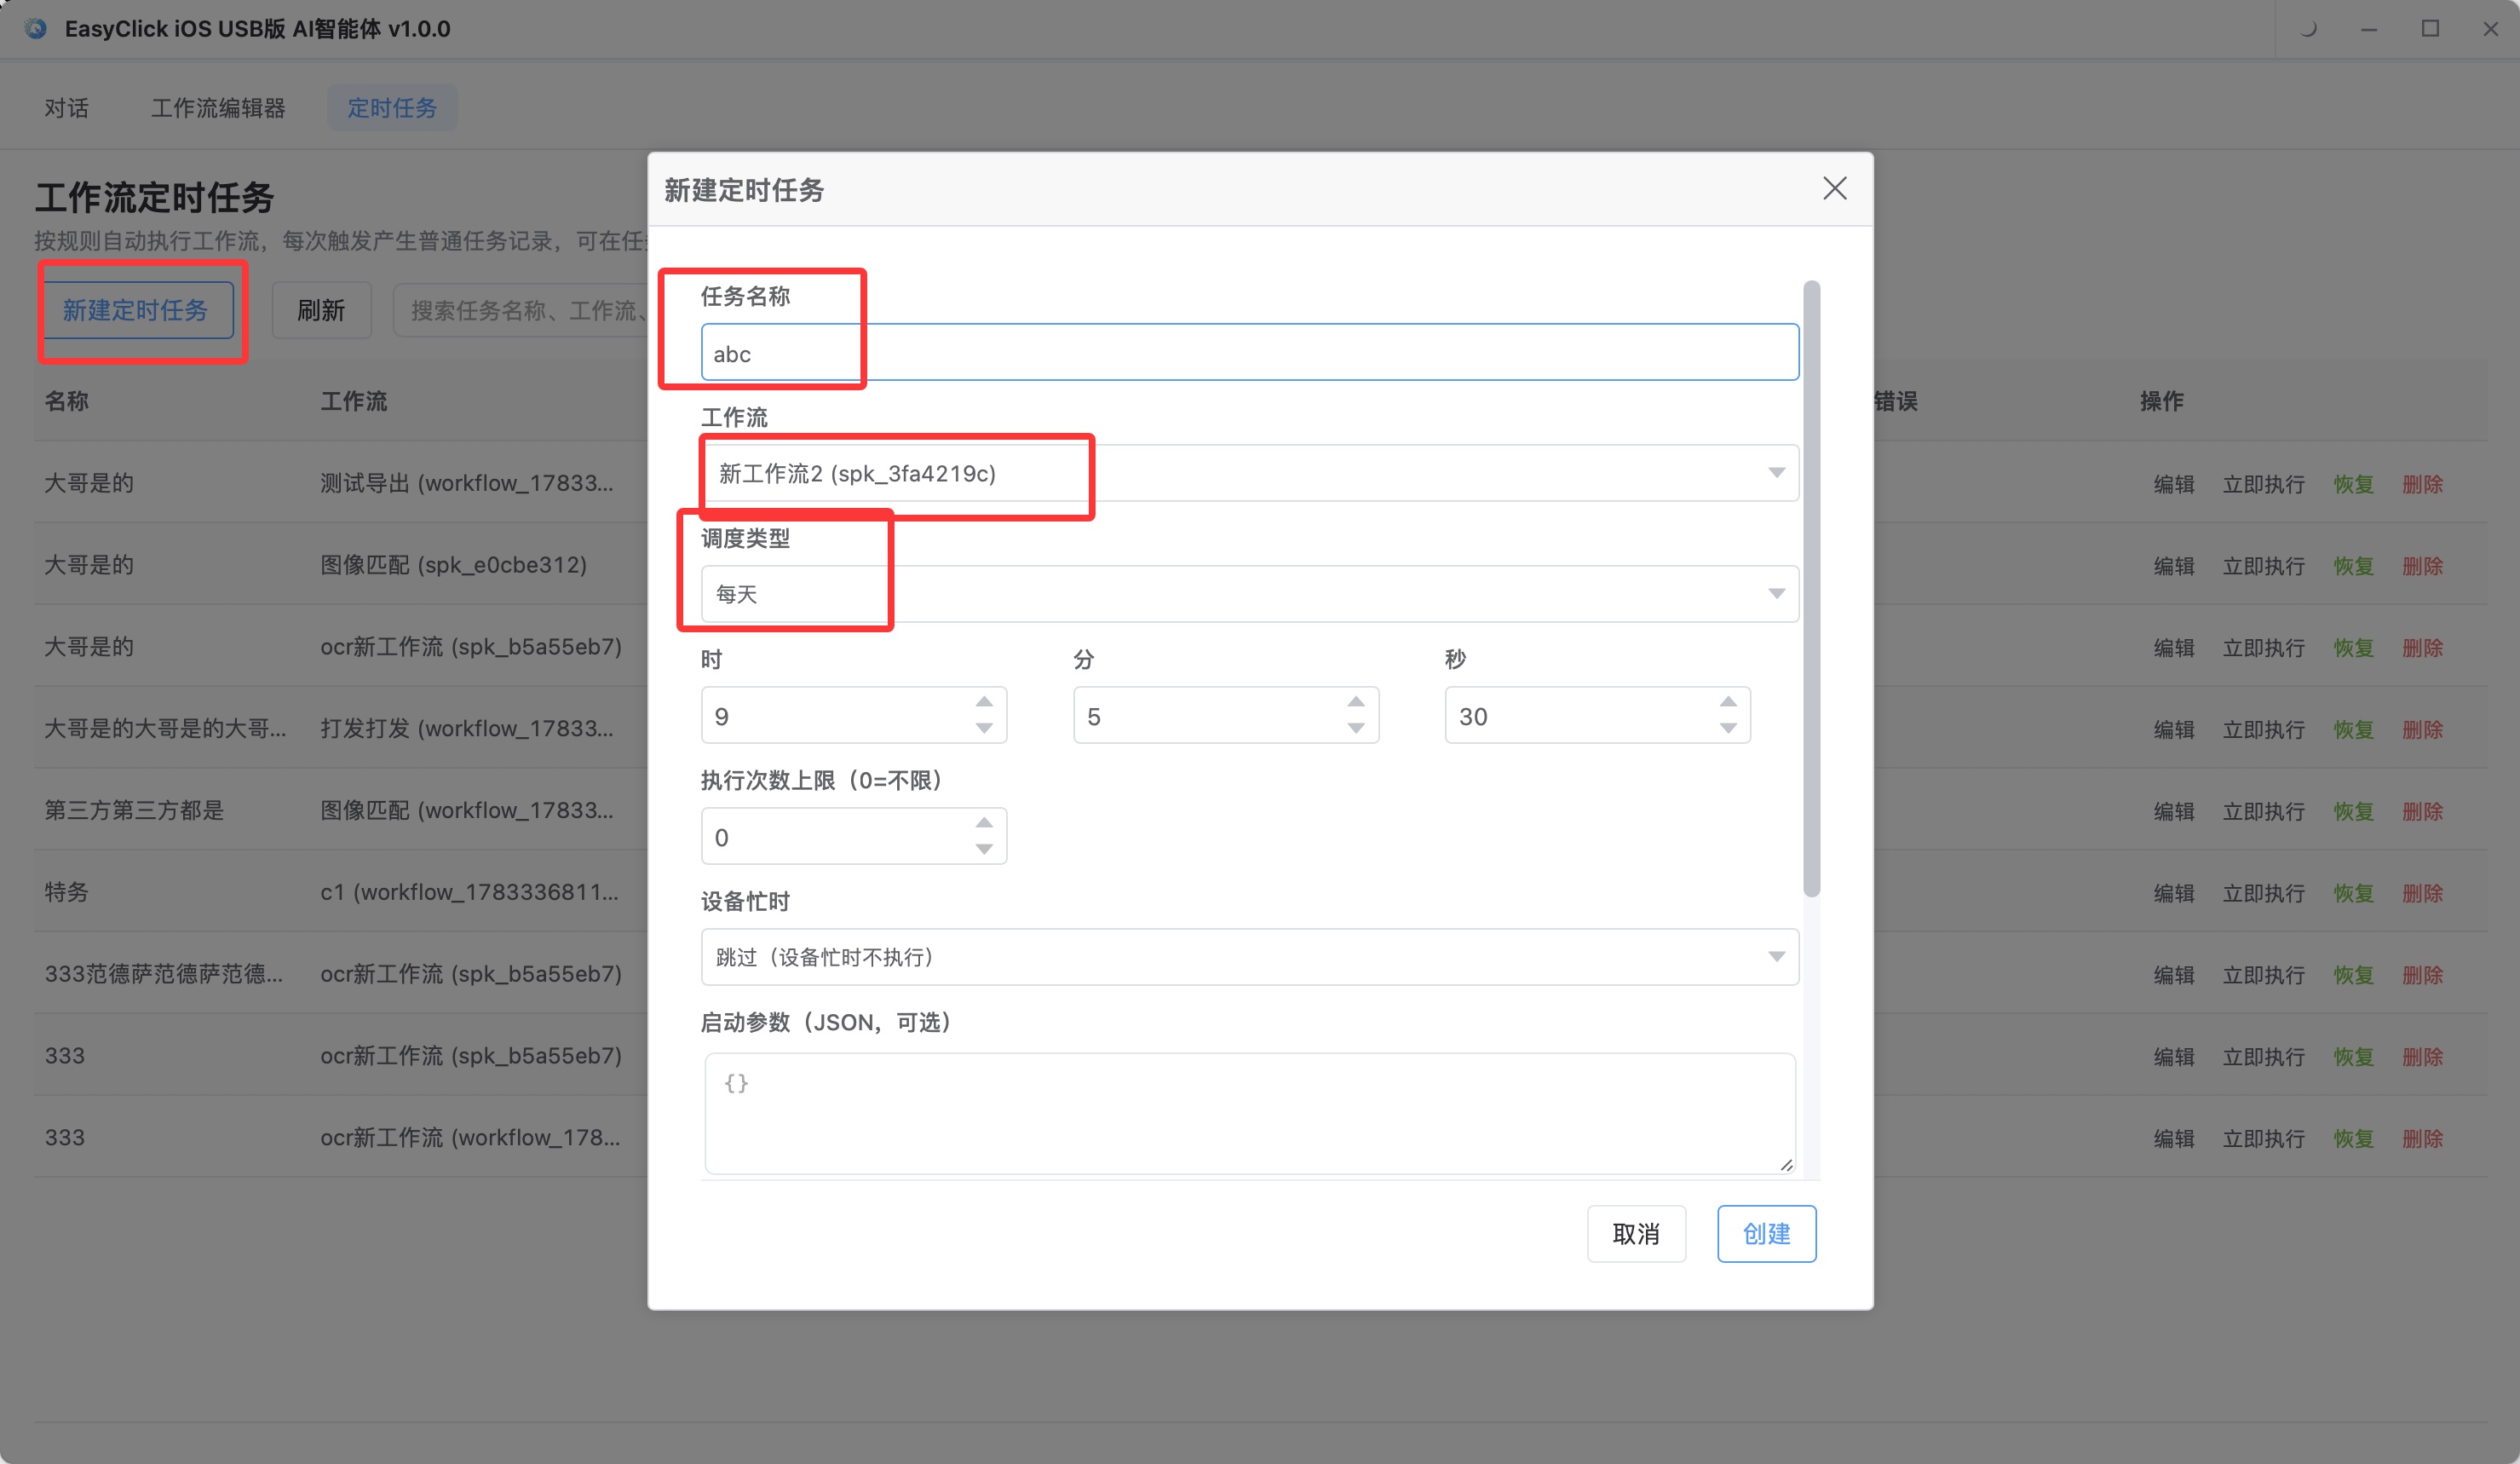
至于「半夜跑」这件事本身,靠的是定时任务:按你设定的时间规则自动运行已保存的工作流,每次触发都会生成一条普通任务,落到同一个任务面板里。所以只要定时任务的规则没错,夜里跑的东西白天是能查到的。
有一个坑值得先说:如果触发时所有目标设备都被跳过(比如设备正忙),这次触发会算作失败,失败原因记在定时任务列表的「最近错误」列里。这时候任务面板里是看不到任何记录的——它根本没生成任务。排查「任务没跑」的时候,这两个地方都要看。
第二步:让它主动找你
光能查到还不够,你要的是「它出事了会来敲你」。
脚本里可以直接往钉钉机器人发消息。EC USB 6.16.0 以上的版本提供了这个函数,传入机器人 Webhook 地址、密钥和消息内容,还能指定 @ 谁或者 @ 所有人:
function main() {
  let url = "https://oapi.dingtalk.com/robot/send?access_token=你的token";
  let secret = "你的密钥";   // 也可以不写,改用关键字过滤方式
  var res = sendDingDingMsg(url, secret, "夜间发布任务失败,请查看任务面板", "", true);
  logd("告警返回:" + res);
}

main();
返回值是一个 JSON 字符串,errcode 等于 0 代表发送成功,其他值都是错误。这个返回值一定要打日志——不然告警通道自己坏了你都不知道。
最小的可用做法,是把这段调用放进脚本的异常分支:任务出错就推送。更进一步的做法是在关键节点主动上报进度,比如「30 台设备全部完成」「有 4 台失败」,这样你不只能知道出事了,还能知道结束时的状态。
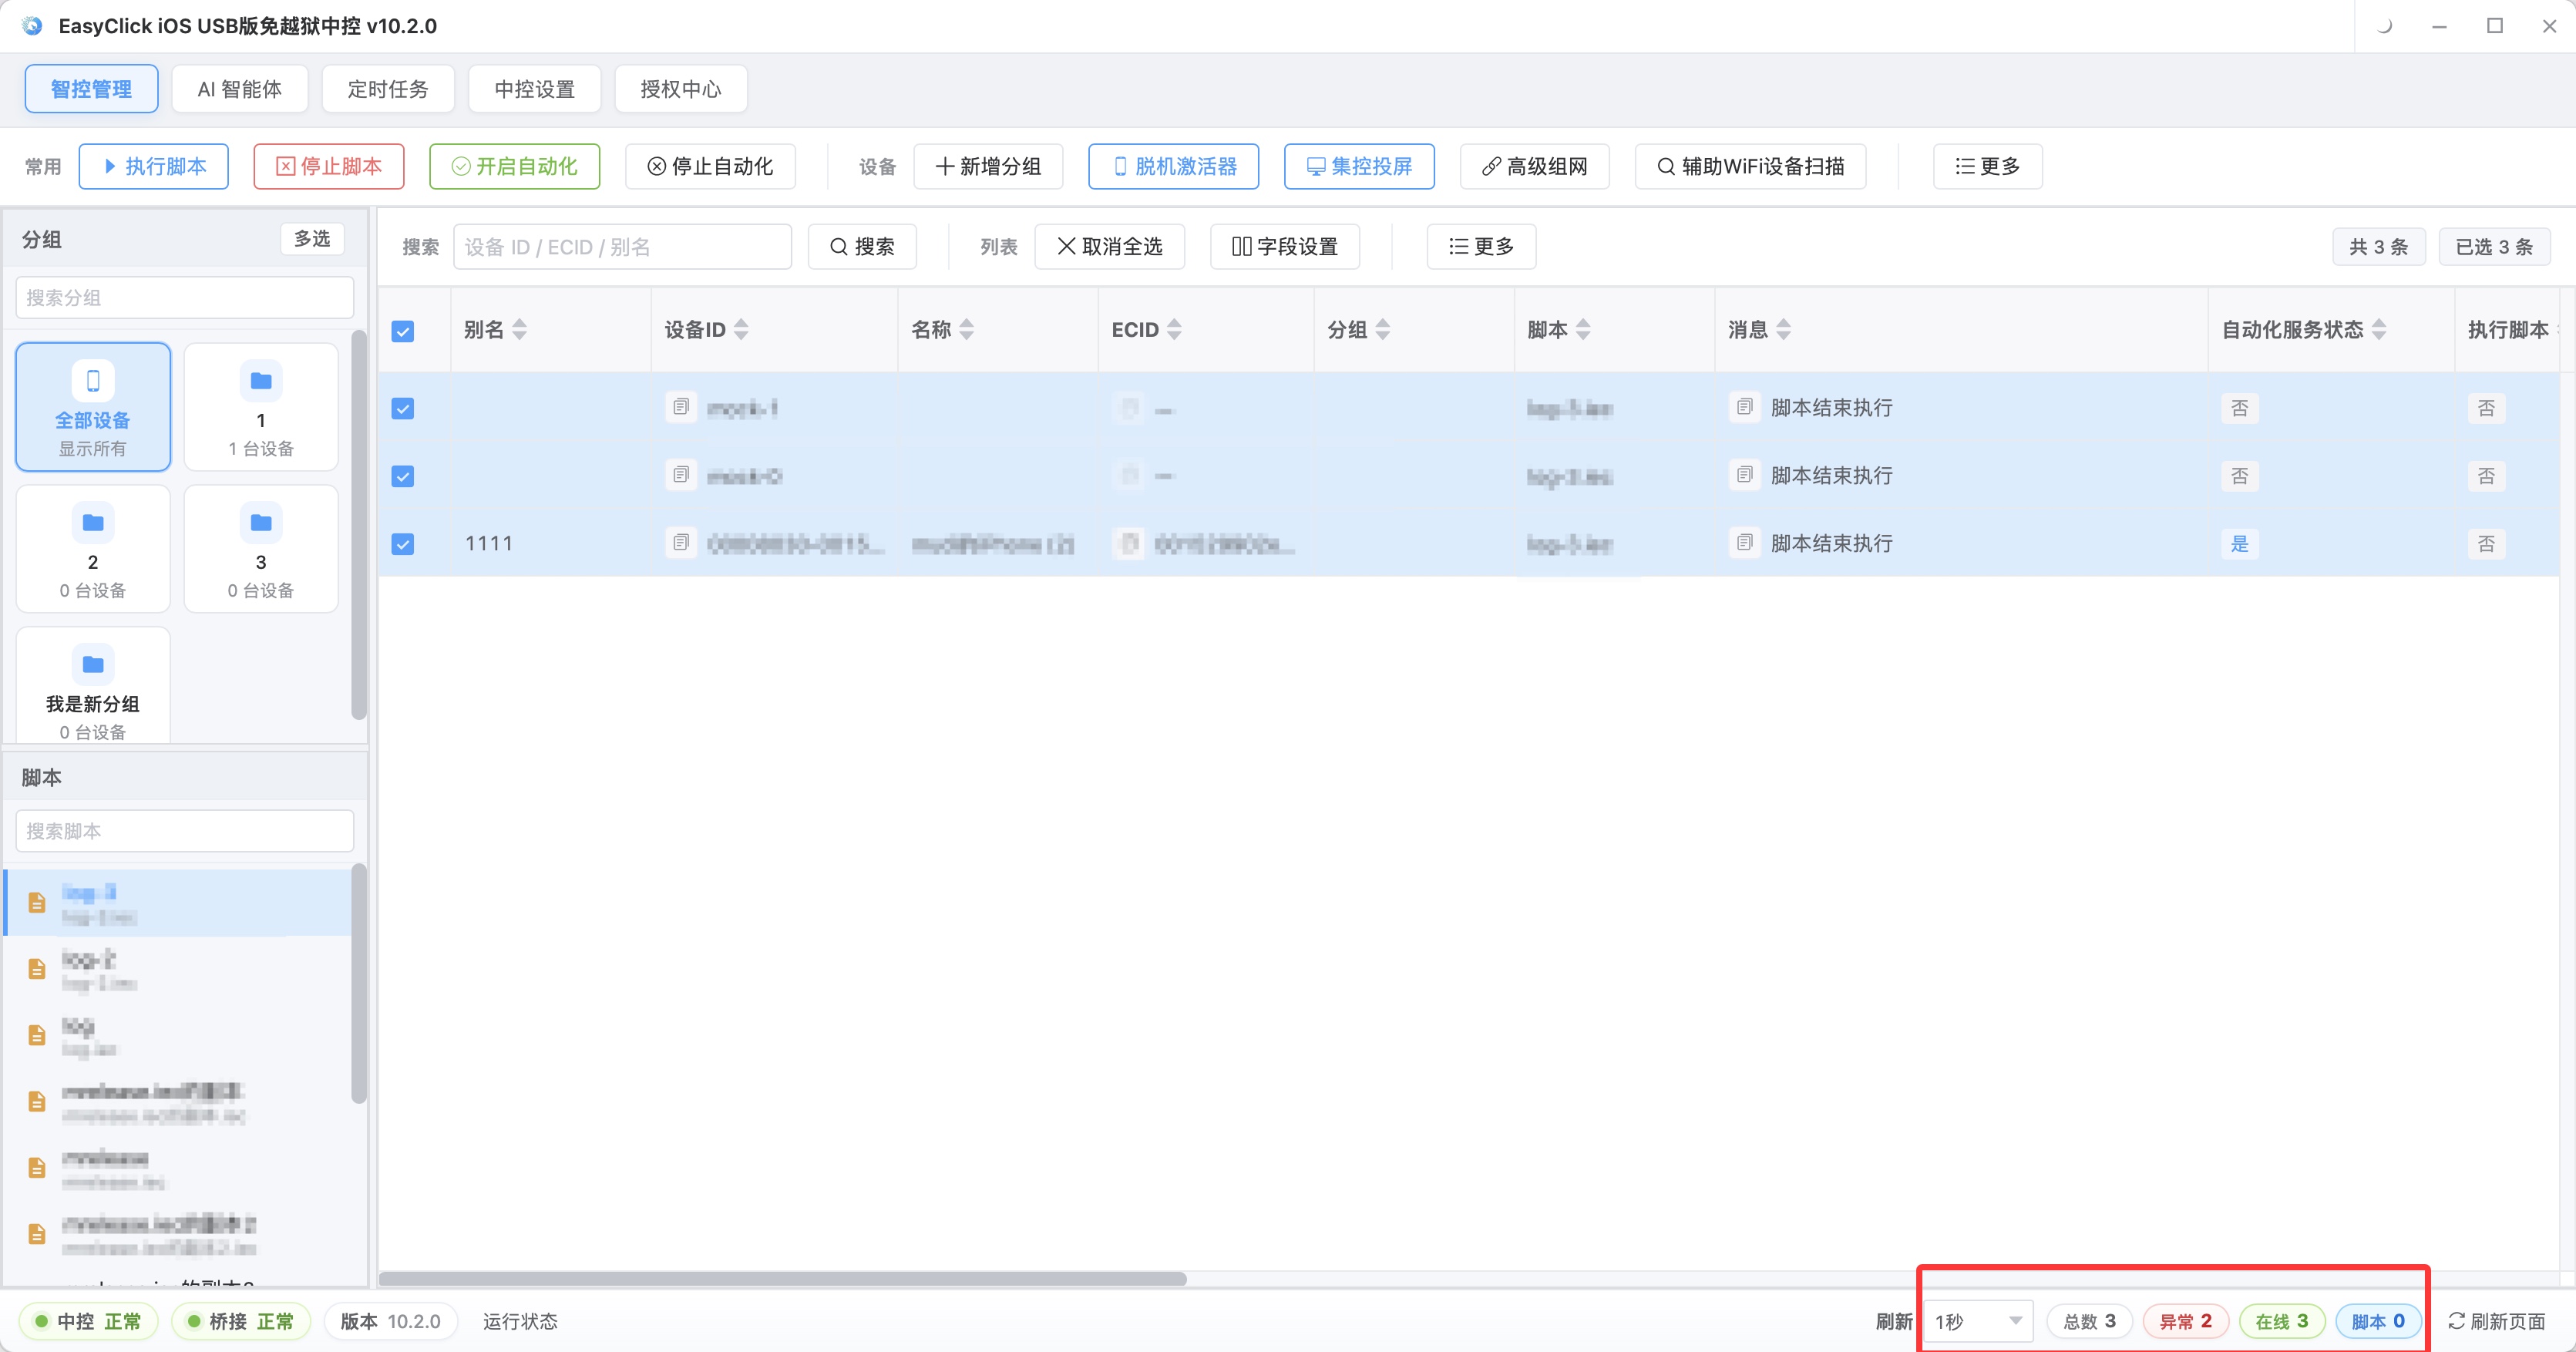
和告警配套的是运行日志。任务失败后到日志里看详细记录,能定位到具体停在哪一步——是没找到元素、还是加载超时、还是权限弹窗挡住。日志在任务面板里能直接打开,编辑器里回放失败步骤时也会标出原因。
第三步:告警该覆盖哪几类事件
只接一个「任务失败就通知」是不够的。实践中至少覆盖四类,前两类是业务层,后两类是基础设施层:
- 任务整体失败:整批没跑成,影响当天交付。
- 单台设备连续多次失败:一台不算事,同一台连着好几次就要看了——多半是那台机器的问题,不是脚本的问题。
- 设备掉线超过设定时长:比如离线超过两小时就通知。这条能抓住「设备自己在夜里掉了」这种情况,而任务面板不一定能反映出来。
- 授权或环境异常:授权到期这种事最坑,因为脚本根本没跑起来,也就不会触发任何告警。它需要一个独立的定时检查,而不是等着脚本报错。
第四步:告警要分级,不然会变成噪音
这一步很多人跳过,然后在一周之内对告警免疫。
全天候推送的结果是:半夜被叫起来三次,其中两次是单台设备的小问题。第三天开始你就把通知静音了,第四天真正的事故来的时候你没看见。
建议分两级:
| 级别 | 什么情况 | 怎么处理 |
|---|---|---|
| 立即通知 | 整批任务失败、关键时段的关键任务没跑、大面积掉线 | 推送到手机并 @ 人 |
| 攒着看 | 单台设备失败、非关键时段的小范围异常、部分成功 | 攒成一条早报,早上一起看 |
分级的关键是把「@ 人」留给真正需要起床的那一类。如果所有告警都 @ 所有人,等于都没有 @。
还有一条边界要说清楚:告警是给你争取时间的,不是替你解决问题的。半夜收到告警之后,如果处置流程本身没想好——比如「挂了之后是先重跑还是先停」都没定——那爬起来也只是盯着屏幕。这个判断最好在白天想清楚,写进流程里。
别让告警自己失效
告警通道坏掉这件事很隐蔽:消息发不出去,但脚本不报错,你以为一切正常。
三种最常见的失效方式:
- 机器人配置失效。密钥或地址过期、群机器人被移出、关键字过滤规则改了但对不上。
- 授权到期。前面提过,这种情况下脚本压根没启动,不会有任何告警。
- 中控所在电脑的问题。关机、断网、系统更新重启——这个最容易被忽略,因为整套告警链路都跑在这台机器上。
应对办法是加一条反向自检:每天固定时间主动发一条测试消息,确认通道是通的。另外把授权有效期也纳入检查——返回授权信息的函数可以查到期时间,把它做成一条定时任务,快到期时提前通知你。
收到告警之后按什么顺序处理
最后说处置顺序,四步:
- 先看影响面。任务是全部失败还是部分成功?范围决定后面怎么动。
- 点开任务看明细。哪几台设备、错误说明是什么、有没有集中在某个特征上(同一批线材、同一个系统版本)。
- 到运行日志里定位。失败停在哪一步、有没有截图留证、之前几步是否正常。
- 最后才决定动作。是重跑、是跳过问题设备、还是要改脚本。
顺序颠倒最常见的结果是:一看失败就急着重跑,结果把同一个问题重复一遍,还把现场毁了。先判断,再动手。
最后
回到深圳那位朋友。他后来把告警接上了,据他说最大的变化不是少出事故,是睡觉踏实了。
苹果群控要做到无人值守,前提不是脚本永远不挂——那是做不到的。前提是它挂了你知道,而且知道该做什么。
先做最小可用版本:定时任务建起来、任务面板四个字段看熟、异常分支里加一次钉钉告警调用。通常一个下午就够。剩下的时间花在分级和通道自检上,比追求告警项越全越好更有价值。
设备侧如果已经在做人工巡检,那篇可以配合着看:苹果群控设备巡检怎么做。定时任务本身怎么建,参考AI 智能体定时任务怎么配。
iEasyClick:手机自动化脚本与群控方案站,覆盖安卓免 root、iOS 免越狱、鸿蒙 Next,提供脚本开发教程、中控投屏与批量运维方案。官网 ieasyclick.net
想要真实跑起来?
本文介绍的方案均可基于 EasyClick 能力在 iEasyClick 落地。官网提供完整文档、开发工具与自动化产品,免费体验。